容器逃逸(Container Escape)是指运行在容器内的进程突破容器隔离边界、获得宿主机(Host)操作系统权限的攻击行为。Docker 等容器技术依靠内核命名空间与控制组实现资源隔离,但这种隔离并非虚拟机级别的硬隔离——容器与宿主机共享同一个内核,一旦内核或运行时存在漏洞、或容器被赋予过高权限,攻击者就可能”越界”控制宿主机本身。理解容器逃逸的原理与常见路径,能帮助运维者在部署 Docker 服务时识别真正的风险点,而不是笼统地认为”用了容器就安全”。本文帮助读者从隔离机制、典型逃逸路径到基础防护清单,建立对这一安全概念的完整认知。
容器隔离的定义与隔离边界如何构建
要理解逃逸,先要理解容器靠什么把自己”关起来”。Docker 容器的隔离由三类内核机制共同支撑,三者缺一不可:
- 命名空间(Namespace):让容器内的进程拥有独立的进程编号、网络栈、挂载点、用户编号等视图,容器内看到的”世界”与宿主机互相不可见。
- 控制组(cgroups):限制容器能使用的 CPU、内存、设备等资源配额,防止单个容器耗尽宿主机资源。
- capability 与 seccomp:裁剪容器内进程可用的系统调用与特权操作,默认的 Docker 配置会移除大部分高危能力。
这三层机制叠加后,容器内的普通进程确实难以直接触及宿主机。但关键区别在于:虚拟机通过独立的内核实现硬件级隔离,而所有容器共享宿主机的一个内核。内核一旦被攻破,边界即告失守——这正是容器逃逸与虚拟机逃逸在风险模型上的本质差异,也是安全社区普遍认为”容器隔离强度低于虚拟机”的技术原因。对隔离强度差异的底层逻辑,可延伸阅读站内什么是 VPS词条中对虚拟化层级的说明。
常见的容器逃逸路径有哪些
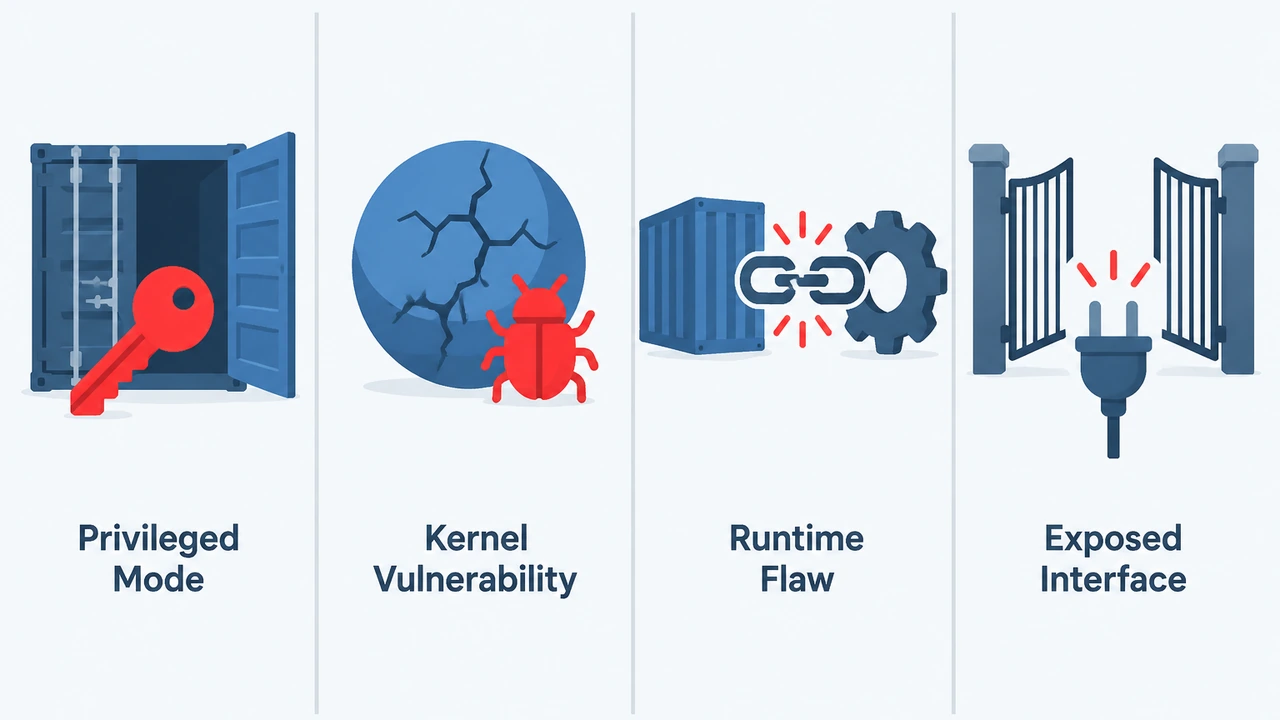
实际发生的容器逃逸极少依赖单一技巧,多数是对错误配置或已知漏洞的组合利用。从公开漏洞库与应急响应案例看,逃逸路径可以归纳为四类,其中配置类问题占实际事件的大头:
第一类是特权容器滥用。以 --privileged 参数启动的容器几乎拥有宿主机全部设备与内核能力,容器内进程可以直接读写宿主机磁盘设备(如 /dev/sda)、加载内核模块,等同于把隔离边界整个拆除。安全厂商 Sysdig 在 2021 年的云安全报告中统计,生产环境中约有一半容器携带不必要的过高权限,这类”为了图省事加的参数”是逃逸事件最常见的入口。
第二类是内核漏洞利用。容器与宿主机共享内核,任何可被容器内代码触发的内核漏洞都可能成为逃逸跳板。例如 2022 年披露的 Dirty Pipe(CVE-2022-0847)内核漏洞,允许绕过文件只读限制改写容器镜像内的文件,配合特定场景可越权修改宿主机文件;更早的 Dirty COW(CVE-2016-5195)也曾被用于容器环境提权。这类逃逸的防御核心是及时更新宿主机内核。
第三类是容器运行时与挂载缺陷。容器运行时组件(如 runc)自身的漏洞同样会造成边界失效,2019 年披露的 runc 漏洞 CVE-2019-5736 允许恶意镜像在容器启动过程中覆写宿主机上的 runc 二进制文件,进而以 root 身份执行任意命令。挂载敏感路径是另一类典型问题:把 Docker Socket(/var/run/docker.sock)、宿主机根目录或 SSH 私钥目录直接挂进容器,等于把宿主机控制权交给了容器内进程。
第四类是内核暴露面过大。默认的 seccomp 与 capability 裁剪会封住大部分系统调用,但如果启动容器时使用了 --cap-add SYS_ADMIN 等高危授权,或关闭了 seccomp 过滤,攻击者就能借助 cgroup 释放、核心调度等内核机制完成越界。此类逃逸不需要任何软件漏洞,纯粹由配置失误导致。
如何判断容器环境是否存在逃逸风险
四种路径的成因各不相同,检测手段也随之分化:配置类风险看启动参数与挂载清单,漏洞类风险看内核与运行时版本。排查可以按下面的顺序进行,每一步都有明确的判定依据:
- 检查容器启动配置:运行
docker inspect <容器名>,重点看Privileged是否为 true、CapAdd中是否出现SYS_ADMIN等高危能力、Binds中是否挂载了 docker.sock 或宿主机根目录。 - 核对宿主机内核版本:运行
uname -r,对照已公开的内核提权漏洞列表,确认是否停留在包含 Dirty Pipe 等已知漏洞的旧版本上。 - 确认运行时组件版本:运行
runc --version与docker version,确保 runc 已修复 CVE-2019-5736(1.0-rc6 之后版本),Docker 自身也在受支持的生命周期内。 - 审计镜像来源:非官方仓库的镜像可能内置挖矿或后门程序,启动即尝试提权。可用
docker history <镜像>查看构建层,或接入 Trivy、Grype 一类镜像扫描工具批量检测。
除静态检查外,持续的运行期监控同样必要。将容器日志与审计日志(如 Linux auditd 对敏感系统调用的记录)接入集中分析,能捕捉”容器内进程尝试挂载宿主设备、访问 /proc/sys”等逃逸前兆行为。对托管在云服务器上的 Docker 业务,还可以直接使用安全组与云监控的组合,缩小暴露面并留存证据。
基础防护清单与部署应用建议
排查之后,防护要落到日常部署规范里。下面这份清单按”效果与成本的比值”排序,前三项不需要额外预算即可完成,也是绝大多数逃逸事件的直接解药:
- 关闭特权模式:默认不用
--privileged;确需访问特定设备时,用--device精确放行单个设备,而不是开放全部能力。 - 收紧挂载与授权:绝不把 docker.sock 挂进不受信任的容器;用
--cap-drop ALL后按需--cap-add,保持默认 seccomp 配置开启。 - 保持内核与运行时更新:订阅发行版安全通告,内核补丁发布后尽快重启切换;runc、containerd 与 Docker 同步升级。
- 以非 root 运行容器:Dockerfile 中声明
USER指令,配合 user namespace 重映射(--userns-remap),即使容器内被攻破,获得的也只是低权限映射用户。 - 敏感业务用虚拟机隔离:多租户或运行不可信代码的场景,把每类负载放进独立虚拟机,容器只作为虚拟机内的部署形态,形成”虚拟机硬边界 + 容器软边界”的纵深结构。
对这些做法的效果,行业内已有量化对比:美国国家标准与技术研究院(NIST)在 SP 800-190 容器安全指南中明确,将容器以非特权模式运行并启用镜像签名验证,可以阻断公开案例中超过七成的逃逸路径。这份指南也是企业制定容器安全基线时的主要参考依据。在部署形态上,独立服务器与 VPS(虚拟专用服务器)用户可参考站内Docker 分类下关于容器部署的系列文章;若需要从操作系统层面加固宿主机,Linux 启动故障排查与综合加固技巧中的系统维护流程同样适用于宿主机例行巡检。
常见误区与常见问题
围绕容器逃逸存在几个流传较广的误解,逐条澄清可以避免防护资源投错方向。
- 误区一:”容器内是 root,但反正出不来”。容器内 root 加默认配置虽然受 capability 裁剪约束,但任何一项配置放宽(挂载、特权、内核漏洞)都可能让这句话失效,不能把隔离寄托在单一层上。
- 误区二:”装了镜像扫描就安全了”。扫描只能发现镜像内的已知漏洞,无法覆盖运行期的错误配置与内核层风险,三者需要分别检查。
- 误区三:”用了 Kubernetes 就不用关心逃逸”。K8s 本身也运行在内核之上,Pod 的 securityContext 配置不当同样会逃逸;编排层解决的是调度问题,不是隔离问题。
容器逃逸和虚拟机逃逸有什么区别?
两者的攻击目标不同:容器逃逸突破的是命名空间与 capability 构成的软边界,攻破后直接获得共享内核的控制权;虚拟机逃逸则需要攻破虚拟机监控器(Hypervisor),攻击难度高一个量级。因此安全等级要求极高的多租户场景,行业惯例仍是以虚拟机为主要隔离单元。
Docker 默认配置够安全吗?
对大多数内部业务而言,默认配置(seccomp 开启、capability 裁剪、无特权)已经能抵御常见攻击,前提是宿主机内核保持更新。需要额外加固的是暴露在公网的容器服务——这类负载建议叠加非 root 用户、只读根文件系统(--read-only)与网络隔离策略。
发现疑似逃逸行为应该先做什么?
首先隔离而不是删除:暂停可疑容器并保留其文件系统与日志用于取证;随后在宿主机上核对进程列表、计划任务与 SSH 授权密钥,确认攻击者是否已在宿主机建立持久化;最后再升级内核与运行时并重建容器。直接删除容器会丢失最重要的溯源证据。
总结
容器逃逸的本质,是利用共享内核这一架构特性,借助过高权限、敏感挂载或内核与运行时漏洞突破隔离边界。对运维者而言,可执行的防护路径是:先用 docker inspect 等命令完成一次全量配置体检,再按”关闭特权、收紧挂载、及时更新内核与 runc、非 root 运行”的顺序落实基线,最后对多租户等高风险负载引入虚拟机级隔离。建议把容器配置检查纳入例行巡检,与内核补丁管理同步执行;如果你需要进一步评估托管环境的容器安全方案,可以先从文中引用的 Docker 分类与宿主机加固文章入手,再结合自身业务形态做加固取舍。
参考来源:
 微信扫一扫打赏
 支付宝扫一扫打赏